إعداد: م. نادية عبد الجواد
- مقدمة
- نموذج التجزئة الشامل الإصدار الثاني SAM 2
- 1.2. التجزئة البصرية القابلة للتوجيه
- 2.2. البنية المعمارية
- 3.2. آلية العمل
- 3. نموذج التجزئة الشامل الإصدار الثالث SAM3
- 1.3. محرك البحث
- 2.3. البنية المعمارية
- 3.3. مقارنة نموذج سام بإصداره الثالث مع نماذج تجزئة أخرى
- 4. دراسة مقارنة لأداء الإصدارات الثلاثة لنموذج التجزئة الشامل SAM
- 5. الإصدارات الأخرى لنماذج التجزئة الشامل SAM
- 6. الخاتمة
- 7. المراجع
1. مقدّمة
يُعَدّ “ميتا” Meta من أبرز الجهات التي أسهمت في تطوير نماذج التجزئة الشاملة، وذلك من خلال إطلاق نموذج Segment Anything Model – SAM عام 2023، الذي مثّل نقلةً نوعيّةً في مجال تجزئة الصور. فقد أتاح النموذج في إصداره الأوّل آليّةً تفاعليّةً بسيطةً وفعّالةً تقوم على النقر على عددٍ محدودٍ من البكسلات للحصول فورًا على قناعٍ دقيقٍ للغرض المستهدف. ومع ذلك، فقد اقتصر نطاق عمله آنذاك على تجزئة الصور الثابتة دون دعمٍ مباشرٍ للمشاهد المتحرّكة.
ولمواكبة الحاجة إلى معالجة المحتوى المرئيّ الديناميكيّ، جاء الإصدار الثاني “سام 2” SAM 2 ليوسّع حدود النموذج نحو الفيديوهات، مقدّمًا تجزئةً فوريّةً موجّهةً بالتلقينات ضمن المشاهد المتحرّكة، وبكفاءةٍ أعلى في تتبّع الأغراض عبر الإطارات المتعاقبة.
أمّا الإصدار الأحدث،نموذج “سام 3” SAM 3، فيمثّل خطوةً مفاهيميّةً متقدّمةً؛ إذ لم يعُد يقتصر على تجزئة العناصر التي يُشار إليها بالنقر فحسب، بل أصبح قادرًا على تجزئة المفاهيم التي يصفها المستخدم لغويًّا، بما يعكس انتقالًا من التفاعل البصريّ المباشر إلى الفهم الدلاليّ للمحتوى.
وفي هذه المقالة، سنغوص في البُنى المعماريّة لكلّ إصدارٍ من إصدارات نماذج التجزئة الشاملة، مع تحليلٍ علميٍّ منهجيٍّ يُبرز أوجه التطوّر التقنيّ بينها، لتكون مادّةً مرجعيّةً رصينةً للباحثين والمهتمّين في هذا المجال.
2. نموذج التجزئة الشامل الإصدار الثاني SAM 2
يُعدّ نموذج”سام 2″ SAM 2 نموذجَ أساسٍ تفاعليًّا وقابلًا للتوجيه لتجزئة الأغراض [1].
- وتعني قابليّةُ التوجيهِ أنّه يمكن للمستخدم النقرَ أو سحبَ مربّعاتِ إحاطةٍ حول غرضٍ واحدٍ أو عدّةِ أغراضٍ يرغب في تجزئتها، ليقومَ النموذجُ بالتنبّؤِ بقناعٍ يعزلُ الغرضَ ويتتبّعُه عبر المقطعِ المُدخَلِ.
- أمّا كونه تفاعليًّا، فيعني إمكانيّةَ تعديلِ التلقيناتِ ديناميكيًّا أثناءَ التشغيلِ، مثلَ إضافةِ تلقيناتٍ جديدةٍ في إطاراتٍ مختلفةٍ، بحيثُ تتكيّفُ نتائجُ التجزئةِ تبعًا لذلك.
- وأمّا وصفُه بأنّه نموذجُ أساسٍ للتجزئةِ، فيدلّ على أنّه دُرِّبَ على مجموعةِ بياناتٍ ضخمةٍ، ممّا يتيحُ تطبيقَه على طيفٍ واسعٍ من حالاتِ الاستخدامِ في مجالِ الرؤيةِ الحاسوبيّةِ.
تمَّ تطبيقُ محرّكِ بحثٍ لإنشاءِ بياناتٍ تدريبيّةٍ تحت مسمّى بياناتِ التجزئةِ الشاملةِ للفيديو Segment Anything Video – SA-V، والتي تتكوّنُ من 35.5 مليون قناعٍ موزَّعةٍ على 50.9 ألفِ فيديو، أي بما يزيدُ بمقدار 53 ضعفًا من حيثُ عددُ الأقنعةِ مقارنةً بأيِّ مجموعةِ بياناتٍ أخرى متاحةٍ لتجزئةِ الفيديو. [2]
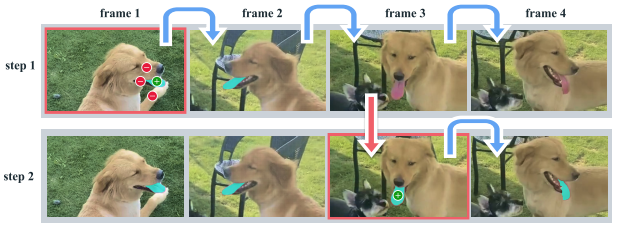
وفقًا للشكِل (2)، ومن خلال تقديم عدة تلقيناتٍ إيجابيةٍ وسلبيةٍ على الغرض المراد تجزئته، والذي في هذه الحالة اللسانُ، يقوم النموذج بعد ذلك بنشر التجزئة إلى الإطارات اللاحقة. وإذا فقد الغرض المستهدف، يمكن للمستخدم التفاعلي إعادةَ استعادةِ الغرض بنقرةٍ واحدةٍ إيجابيةٍ عبرَ تلقينٍ جديدٍ في إطارٍ آخر.
ويتميّز نموذج “سام2 ” SAM 2 عن “سام1” SAM 1 في أنّ الأخير كان سيتطلب عدة نقراتٍ في الإطار الثالث (كما في الإطار الأول) لإعادةِ توثيقِ الغرض بشكلٍ صحيحٍ، نظرًا لأنّ التجزئة كانت تُعاد من الصفر. أما باستخدام ذاكرة سام 2 SAM 2، فيمكن لنقرةٍ واحدةٍ فقط استعادةُ الغرض (اللسانُ) بكفاءةٍ وسلاسةٍ.
1.2. التجزئة البصرية القابلة للتوجيه
يركّز نموذج “سام 2” SAM2 على مهمّة التجزئة البصريّة القابلة للتوجيه Promptable Visual Segmentation – PVS. ففي هذه المهمّة، يُزوَّد النموذجُ بفيديو إدخالٍ وتلقينٍ من المستخدم، مثلَ النقرِ بالنقاط، أو مربّعاتِ الإحاطة، أو الأقنعة، ويُطلَبُ منه التنبّؤُ بما يُعرَف بـ قناعٍ زمانيٍّ-مكانيٍّ Masklet يمتدُّ عبر الإطاراتِ الزمنيّةِ للفيديو.
وبمجرّدِ التنبّؤِ بالقناعِ الزمانيّ-المكانيّ، يمكنُ تحسينُه تكراريًّا من خلالِ تقديمِ تلقيناتٍ إضافيّةٍ في إطاراتٍ أخرى Frames، سواءٌ عبر نقراتٍ إيجابيّةٍ أم سلبيّةٍ (كمّا هو موضّح في الفيديو (1))، ممّا يتيحُ تحديثَ القناعِ المُجزَّأِ بصورةٍ تفاعليّةٍ وديناميكيّةٍ.
الفيديو (1): مثال عملي لنموذج “سام2” SAM2. [3]
2.2. البنية المعمارية
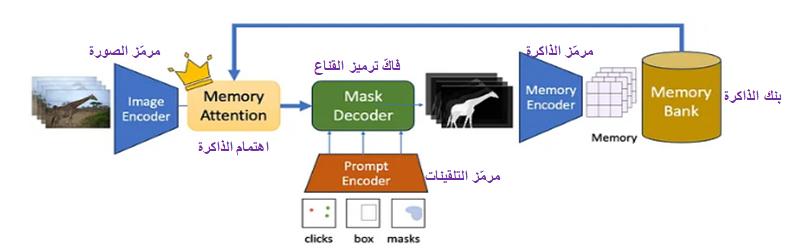
المكوّناتُ الداخليّةُ التي طرأت على نموذجِ سام – الإصدارِ الثاني SAM2 وفقًا للشكلِ (1).
- مرمّز الإطارات Frame Encoder
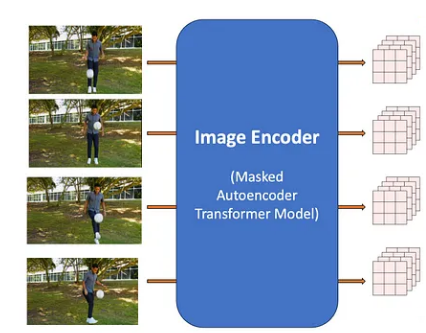
يُقسَّم فيديو الإدخال أوّلًا إلى عدّةِ إطاراتٍ، ثم يُرمَّزُ كلُّ إطارٍ بصورةٍ مستقلّةٍ باستخدام نموذجِ رؤيةٍ حاسوبيّةٍ من نوعِ المشفِّرِ التلقائيِّ المقنَّعِ المعتمدِ على المحوِّلاتِ البصريّة Vision Transformer-based Masked Autoencoder، كما هو موضَّحٌ في الشكلِ (3)، والمعروفِ ببنية “هيرا” Hiera
ويُنتِجُ هذا المُرمِّزُ خريطةَ سماتٍ متعدّدةَ القنواتِ بأبعادٍ تبلغ 256×64×64. وتُعالَجُ جميعُ إطاراتِ الفيديو بالطريقةِ نفسِها باستخدامِ المُرمِّزِ ذاته. [1]
2. مرمّز الذاكرة Memory Encoder
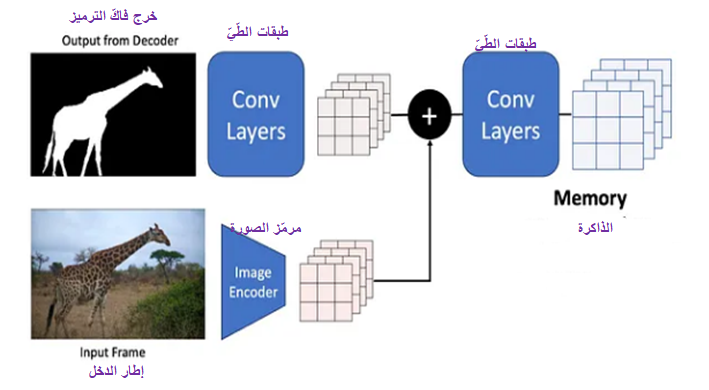
وفقًا للشكلِ (4)، يُجرى أوّلًا خفضُ دقّةِ الأقنعةِ المُرشَّحةِ الناتجةِ باستخدامِ طبقةِ الطيِّ، ثم يُضافُ إلى هذا الناتجِ الترميزُ غيرُ المشروطِ للصورة Unconditional Image Encoding. بعد ذلك، يُمرَّرُ الناتجُ عبرَ طبقاتِ طيٍّ خفيفةِ الوزنِ بهدفِ دمجِ المعلوماتِ بكفاءةٍ أعلى.
وتُسمّى خريطةُ المزايا المكانيّةُ Spatial Feature Map الناتجةُ عن هذه العمليّةِ بـ الذاكرة. ويمكنُ النظرُ إلى هذه الذاكرةِ بوصفِها تمثيلًا مدمجًا يجمعُ بينَ معلوماتِ إطارِ الإدخالِ الأصليِّ والقناعِ المُولَّدِ عندَ لحظةٍ زمنيّةٍ محدّدةٍ من الفيديو.
ويُتيحُ هذا التمثيلُ للنموذجِ الاحتفاظَ بسياقٍ بصريٍّ غنيٍّ يدعمُ فهمَ التغيّراتِ الزمنيّةِ وتتَبُّعَ الأغراضِ بدقّةٍ أعلى عبرَ إطاراتِ الفيديو المتتاليةِ.
3. بنك الذاكرة Memory Bank
يحتوي بنكُ الذاكرةِ على ما يلي: [1]
- يُحتفَظُ بآخرِ عددٍ N من تمثيلاتِ الذاكرةِ ضمنَ بنيةِ قائمةِ انتظارٍ Queue، بحيثُ تُمثِّلُ أحدثَ الحالاتِ المُعالَجةِ.
- يُخزَّنُ آخرُ عددٍ M من التلقيناتِ التي أدخلها المستخدمُ، وذلك بهدفِ تتبُّعِ التفاعلاتِ السابقةِ المتعدّدةِ.
- كما تُحفَظُ وحداتٌ لفظيةٌ لخرجِ مفكِّكِ الأقنعةِ لكلِّ إطارٍ، والتي تعملُ كمؤشِّراتٍ غرضيّةٍ Object Pointers تلتقطُ معلوماتٍ دلاليّةً عاليةَ المستوى حولَ الغرضِ المرادِ تجزئتُه.
4. اهتمام الذاكرة Memory Attention
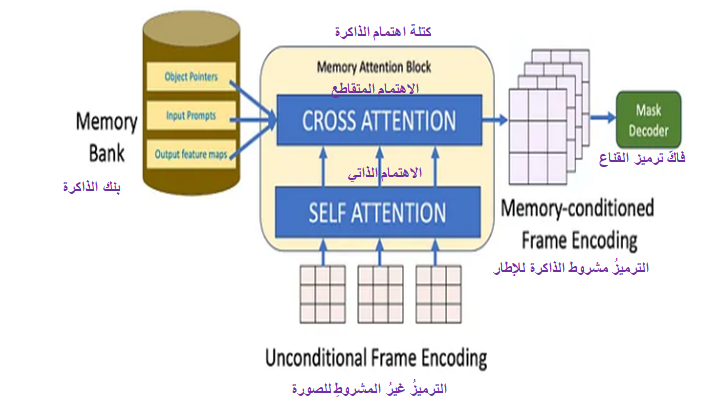
تسمحُ آليّةُ اهتمام الذاكرةِ بدمجِ السياقِ الزمنيِّ والمعلوماتِ المتراكمةِ من الإطاراتِ السابقةِ، ممّا يُعزِّزُ دقّةَ تجزئةِ الأغراض واستمراريّةَ تتبُّعِها عبرَ الفيديو.
وفقاً للشكلِ (5) تقومُ كتلةُ اهتمامِ الذاكرةِ أوّلًا بتنفيذِ الاهتمامِ الذاتيِّ على تضميناتِ الإطارِ، ثمّ تُجري الاهتمام المتقاطعَ بينَ تضميناتِ الصورةِ ومحتوياتِ بنكِ الذاكرةِ. وبهذه الطريقةِ، تُدمَجُ تضميناتُ الصورةِ غيرُ المشروطةِ مع الأقنعةِ الناتجةِ السابقةِ، والتلقينات السابقةِ، ومؤشِّراتِ الأغراضِ، لتوفيرِ سياقٍ غنيٍّ للإطارِ الحاليِّ.
وخلالَ طبقاتِ الاهتمامِ، يُستخدَمُ التضمين الموضعيّ الدّورانيّ ثنائيُّ الأبعادِ 2D Rotary Positional Embeddings إلى جانبِ التموضعِ الاعتياديِّ، ممّا يُتيحُ للنموذجِ فهمَ العلاقاتِ النسبيّةِ بينَ الإطاراتِ وتمثيلَ العلاقاتِ المكانيّةِ الأفقيّةِ والعموديّةِ داخلَ الصورةِ بصورةٍ فعّالةٍ [1].
5. فاكّ ترميز القناع:
مخرجاتُ فاكّ الأقنعةِ [1]:
- أقنعةُ تجزئةٍ متعدِّدةٌ Multiple Segmentation Masks: يتوقّعُ النموذجُ أقنعةً ثنائيّةَ البكسلِ Pixel-wise Binary Masks لتجزئةِ الغرضِ بدقّةٍ على مستوى كلِّ بكسلٍ.
- تقديرُ مؤشِّرِ التقاطعِ على الاتّحادِ Intersection-over-Union – IoU لكلِّ قناعٍ: يتنبّأُ النموذجُ بدرجةِ الثقةِ بشأنِ صحّةِ كلِّ قناعٍ مُتوقَّعٍ.
- تنبُّؤُ الإخفاءِ Occlusion Prediction: يتنبّأُ بما إذا كانَ الغرض المطلوبُ مرئيًّا في الإطارِ الحاليِّ أم محجوبًا.
3.2. آلية العمل
وعليه، فإنه يمكننا تجميع جميع المكونات الداخلية السابقة للنموذج لفهم سير آلية العمل كما يلي: [4]
مكانيًا، يتصرّف النموذج بطريقة مشابهة لنموذج “سام” SAM، إذ يتولى فاكّ أقنعة خفيف الوزن و قابل للتلقين أخذ تضمينات الصورة والتلقينات (إن وجدت) وإنتاج قناع تجزئة للإطار. ويمكن إضافة التلقينات تكراريًا على الإطار نفسه بهدف تحسين القناع وتنقيحه.
وتضمينات الإطار المستخدمة بواسطة فاكّ أقنعة لا تأتي مباشرة من مُرمِّز الصورة، بل هي مشروطة بذاكرة التنبؤات السابقة والإطارات الموجّهة. ومن الممكن أن تأتي بعض الإطارات الموجّهة أيضًا “من المستقبل” بالنسبة للإطار الحالي.
ويتم إنشاء ذاكرة الإطارات بواسطة مُرمِّز الذاكرة استنادًا إلى التنبؤ الحالي، وتُخزَّن في بنك ذاكرة لاستخدامها في الإطارات اللاحقة. وتقوم عملية اهتمام الذاكرة بأخذ تضمينات كل إطار من مُرمِّز الصورة لاستخدامها في معالجة الإطار الحالي.
3. نموذج التجزئة الشامل الإصدار الثالث SAM3
لم تكن الإصدارات السابقة من نموذج “سام” SAM مصمَّمةً لمعالجة مسألة التعرّف الشامل على كلِّ الأغراض المنتمية إلى فئةٍ دلاليّةٍ محددةٍ وتتبعها ضمن المشهد كاملًا.
وسّع نموذج سام SAM نطاق مفهوم التجزئة، فانتقل به من مجرد تنفيذ مهام التجزئة البصرية القابلة للتوجيه، الذي يدعمه نموذج “سام 2 ” SAM2، إلى ترسيخ معيارٍ متقدّمٍ يدعمه “سام 3 “SAM3 لمهمة تجزئة المفاهيم القابلة للتوجيه Promptable Concept Segmentation – PCS
وتقوم هذه المهمة على أنها عمليةٌ تستقبل مدخلاتٍ نصيةً و/أو أمثلةً صوريةً، وتتنبّأ بكلٍّ من أقنعة التجزئة الدلالية وأقنعة الحالات Instance Masks لكلِّ غرضٍ يطابق المفهوم المحدد، مع الحفاظ على هوية الأغراض عبر إطارات الفيديو المتعاقبة. [4]
وللتركيز على التعرّف إلى المفاهيم البصرية الأوليّة، تمّ تقيد المدخلات النصية بعباراتٍ اسميةٍ بسيطةٍ مثل: «تفاحة حمراء» أو «قطٌّ مخطَّط». ورغم أنّ نموذج” سام 3 “SAM3 غير مصمَّمٍ للتعامل مع عباراتٍ مرجعيةٍ طويلةٍ أو استفساراتٍ تتطلب استدلالًا معقَّدًا، فقد تمّ إمكانيةَ دمجه بسهولةٍ مع نموذجٍ لغويٍّ كبيرٍ متعددِ الوسائط للتعامل مع توجيهاتٍ لغويةٍ أكثر تعقيدًا. [4]
يتميَّز هذا الإصدار بقدراتٍ جوهريةٍ تتفوَّق على الإصدارين السابقين [5]، ويمكن تلخيص أبرزها فيما يلي:
- يمتلك القدرة على اكتشاف وتجزئة جميع الأغراض المتوافقة مع التلقين المُعطى بدقَّةٍ عالية.
- في سياق الفيديو، يستطيع تتبُّع الأغراض المُراد تجزئتها عبر جميع الإطارات بكفاءةٍ واستمرارية.
- يدعم أنواعًا متعدِّدة من التلقينات، بما في ذلك التلقينات النصيَّة، والبصريَّة، والتلقينات المُدمجة، إضافةً إلى الأمثلة الصوريَّة.
- يوفِّر دعمًا فعَّالًا لمفهوم المفردات المفتوحة؛ إذ يمكنه تجزئة مفاهيم عامَّة لم يُدرَّب عليها مسبقًا، ممَّا يجعله أداةً قويَّةً ومرنةً في مهام التجزئة.
- لا يقتصر دوره على التجزئة الموضعيَّة، بل يمتدُّ ليشمل البحث الشامل والتتبُّع المنهجي لكلِّ الأغراض المطابقة لمفهومٍ معيَّن ضمن أرشيفاتٍ كبيرة من الصور أو مقاطع الفيديو.
نظرًا لما تنطوي عليه العباراتُ الاسميّةُ النصّيّةُ القابلةُ للتمثيل البصريّ من قدرٍ من الالتباس، اعتمد الباحثون مجموعةً من الإجراءات المنهجيّة للحدّ من هذا الالتباس، وذلك من خلال: [6]
- جمعُ التعليقات والوسوم من خبراءَ متعدّدين لتغطية التفسيرات المختلفة.
- تكييفُ آليّات التقييم بما يسمح بتعدّد التفسيرات الصحيحة.
- تحسينُ إرشاداتِ التوسيم Annotation للحدِّ من مصادر الغموض.
- تضمينُ وحدةٍ متخصّصةٍ داخل النموذج للتعامل مع حالات الالتباس بكفاءةٍ.
وفقاً للجدول (1) أبرز النقاط المختلفة بين الإصدارين الثاني والثالث: [5]
|
الميزة |
نموذج سام بإصداره الثاني SAM2 |
نموذج سام بإصداره الثالث SAM3 |
| نوع التلقين Prompt Type | بصري (نقاط / مربعات / أقنعة) |
نصي، أمثلة صورية، بصري، أو مزيج بينها |
| المخرج لكل تلقين | غرض واحد لكل تفاعل. | جميع الأغراض المطابقة للمفهوم. |
| نطاق المهمة | محلي، على مستوى الغرض الواحد. | شامل، على مستوى المفهوم عبر الإطارات. |
| مفردات | ضمنية، غير معتمدة على اللغة. | مفردات مفتوحة عبر النص مع الأمثلة. |
الجدول (1): مقارنة النقاط الجوهريّة بين نموذجيّ سام 2 وسام 3.[5]
يتميّز نموذج “سام3” SAM3 بقدرته على الكشف عن الكائنات المستهدفة وتجزئتها وتتبع جميع أمثلتها داخل الصورة أو عبر إطارات الفيديو، وذلك اعتمادًا على مُدخل نصّي أو مثال مرجعيّ، كما هو موضَّح في الفيديو (2). فعلى سبيل المثال، تمكَّن النموذج من التعرّف على جميع طيور البطريق في إطارات الفيديو، ومن ثمّ تجزئتها وتتبع حركتها بصورةٍ متواصلة ودقيقة.
في المقابل، يقتصر أداء نموذج “سام2” SAM2 على الكشف عن الكائن المستهدف من خلال تفاعلٍ مباشر يتمثَّل في النقر عليه نقرةً إيجابيّة، ليقوم بعد ذلك بتجزئته وتتبع مساره عبر إطارات الفيديو، كما يظهر في الفيديو (3). غير أنّ إحدى أبرز الإشكاليّات المرتبطة بهذا النموذج تتمثَّل في فقدان تتبّع الكائن المحدَّد أثناء تسلسل الإطارات، ممّا يضطرّ المستخدم إلى إعادة النقر عليه مرّةً أخرى لاستئناف عمليّة التتبّع.
الفيديو (2): مثال عملي لنموذج “سام3” SAM3. [7]
الفيديو (3): مثال عملي لنموذج “سام2” SAM2. [7]
1.3. محرك البحث
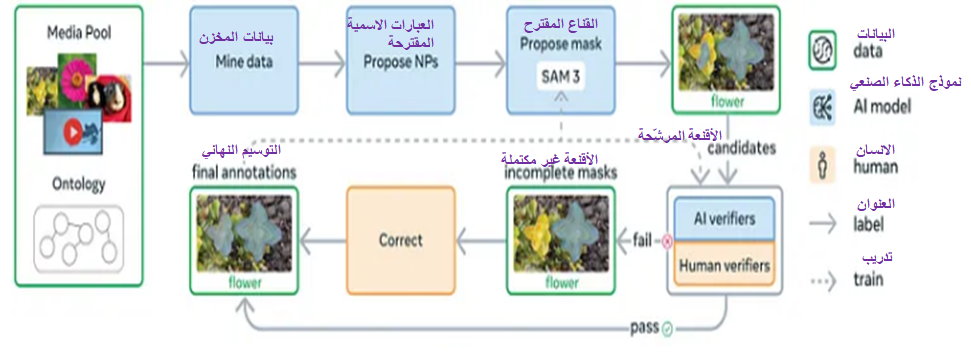
يتفوَّق نموذج سام في إصداره الثالث SAM3 على سوابقه من النماذج، ويُعَدُّ من النماذج الرائدة في مجال التجزئة البصريّة، وذلك نتيجةَ تدريبه على مجموعةٍ ضخمةٍ ومتنوّعةٍ من البيانات والمفاهيم. ووفقًا لما يوضِّحه الشكل (6): [6]
- تمّ إنشاء محرّكَ بياناتٍ تكراريًا، حيث تُستخرج الوسائط من مخزوناتٍ كبيرة.
- تقترح نماذج الذكاء الاصطناعي العباراتِ الاسميّة، ثم يُولِّد نموذج سام3 SAM 3 الأقنعةَ الأوّليّة.
- بعد ذلك، تمرّ هذه الأقنعة بمرحلةِ تحقّقٍ من مستويين:
- أولًا: فحصُ الجودةِ ومدى الصلةِ بالمفهوم.
- ثانيًا: التحقُّقُ من التقاط جميعِ مثيلاتِ المفهوم.
- تُصحَّح حالات الفشل يدويًا، إذ يقوم المعلِّقون بإضافة الأقنعة أو تعديلها أو استبعاد العبارات غير الواضحة.
2.3. البنية المعمارية
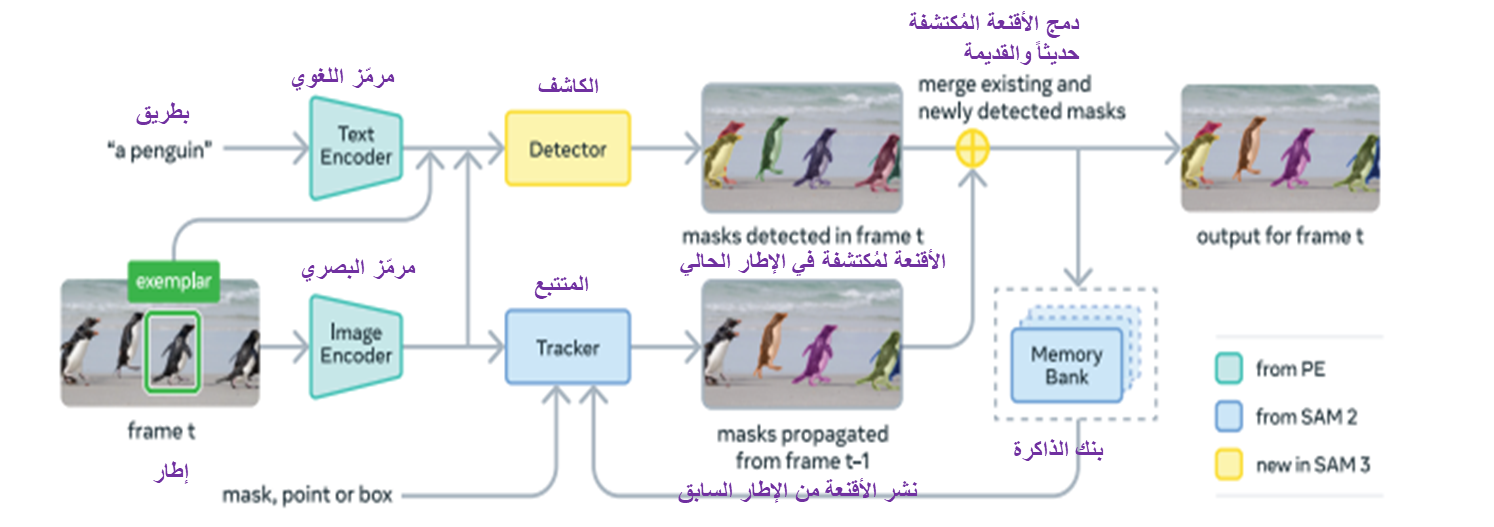
يُوضِّحُ الشكِل (7) معماريّة نموذج سَام إصدار 3 SAM 3، التي تتكوّن من محوّل مُزدَوَج (المرمّز وفاكِّ التَّرميز); وهو كاشف Detector للقدرات على مستوى الصورة والذي يُستخدم بالاقتران مع متتبع Tracker و ذاكرة للفيديو. يقوم كل من الكاشف والمتتبع باستقبال مدخلات الرؤية واللغة. [4]
يوضح الشكل (7) آلية تنوّع التلقينات في النموذج، إذ يمكن أن تأخذ شكل كلمات اسمية، مثل «بطريق»، إلى جانب صورة بصرية توضيحية للغرض المستهدف. في المرحلة الأولى، تُمرَّر الكلمات الاسمية إلى المُرمِّز اللغوي لاستخراج تمثيلات دلاليّة عددية، بالتزامن مع تمرير الصورة التوضيحية إلى المُرمِّز البصري لاستخراج مزايا دلاليّة تعبّر عن خصائص الغرض المستهدف.
بعد ذلك، تُدمَج التمثيلات اللغوية والبصرية داخل بنية الكاشف، الذي يتولّى تحليل الترابط الدلالي بينهما بهدف تجزئة الغرض ضمن الإطار الحالي (t)، وذلك من خلال استخراج جميع الأقنعة المرشّحة ذات الجودة العالية.
في المقابل، يُمرَّر التمثيل الدلالي البصري للصورة التوضيحية إلى وحدة التتبّع، التي تعتمد كذلك على التلقينات المتنوعة من الإطارات السابقة، إضافةً إلى المعلومات المخزَّنة في بنك الذاكرة. وتُستخدَم هذه المعطيات لنشر الأقنعة من الإطارات السابقة إلى الإطار الحالي، بما يضمن الاتساق الزمني واستمرارية تتبّع الغرض.
وفي المرحلة الختامية، يُدمَج خرج الكاشف مع خرج المتتبّع لإنتاج الأقنعة المكتشفة حديثًا، إلى جانب الأقنعة المتتبَّعة من الإطارات السابقة، ثم تُخزَّن المعلومات المُحدَّثة في بنك الذاكرة لدعم المعالجة اللاحقة. وعند تحرّك البطريق في الفيديو، يستخدم المتتبّع المعلومات المخزَّنة في الذاكرة للتعرّف على الغرض ذاته وتحديث قناعه في كل إطار. وتستمر هذه العملية بصورة تكرارية عبر جميع إطارات الفيديو، بما يضمن دقّة التجزئة واتساقها الزمني.
- بنية الكاشف Detector:
يعتمد الكاشف على مُحوِّل الكشف عن الأغراض Detection Transformer – DETR، ويعمل كما يلي: [6]
- المُرمِّز: يقوم بترميز الصورة، والتعليمات النصية، وأمثلة الصور.
- الدمج عبر الانتباه المتبادل: يتم دمج هذه المدخلات من خلال آلية الانتباه المتبادل.
- استعلامات الأغراض: يستخدم استعلامات الأغراض لإنتاج تنبؤات الصناديق التصويرية والتصنيف، لتحديد ما إذا كان كلُّ غرضٍ يطابق التعليمات النصية أم لا.
- رؤوس للتقسيم: يشمل رأس القناع MaskFormer-style ورأس التقسيم الدلالي.
رمزُ تواجُدٍ عامٍّ مُتعلَّم Global Presence Token يُعَدُّ مكوِّنًا معماريًّا مستقلًّا يُسهم في فصل مهمتَي التعرّف وتحديد الموقع فصلًا منهجيًّا دقيقًا؛ إذ يضطلع حصريًّا بمهمة التنبؤ بوجود المفهوم المستهدف، المُعبَّر عنه بصيغة عبارةٍ اسميةٍ، ضمن الصورة أو الإطار المرئي. [4]
أمّا نماذجُ الصورِ التوضيحية Image Exemplars، فتُعالَج من خلال آليةِ ترميزٍ منفصلةٍ لكلِّ مثالٍ صوريٍّ بواسطة مُرمِّزٍ مُخصَّصٍ؛ حيث يُستخدَم تضمينٌ للموقع، وتضمينٌ للعنوان Label، إضافةً إلى مزايا بصريةٍ مُستخلَصةٍ. ثم تُدمَج هذه التمثيلاتُ في بنيةٍ موحَّدةٍ، وتُعالَج بواسطة مُحوِّلٍ صغيرٍ لتوليد تمثيلٍ سياقيٍّ مُحسَّنٍ. وفي المرحلة النهائية، يُضاف هذا التمثيلُ إلى التلقينات النصية ليُشكِّلا معًا وحداتِ لفطية التلقين Prompt Tokens ضمن الفضاء التمثيليِّ المشترك. [4]
2. بنية المتتبعّ Tracker:
يُضيف النموذج مُتتبِّعًا قائمًا على الذاكرة. [4]
- يقوم الكاشفُ بالعثور على أغراضٍ جديدةٍ في كلِّ إطارٍ.
- يقوم المُتتبِّعُ بنشر القناع المصغَّر Masklets، وهي أقنعةٌ مكانيةٌ زمانيةٌ خاصّةٌ بالغرض، Mt-1 من الإطارات السابقة عند الزمن t-1، إلى مواقعها الجديدة Mt في الإطار الحالي عند الزمن t.
- تقوم خطوةُ المطابقة بدمج الأغراض المُتتبَّعة مع الاكتشافات الجديدة (أقنعةِ أغراضٍ جديدةٍ).
ولمعالجة حالات الالتباس، تُزوَّد الأقنعةُ المصغَّرة بدرجةِ اكتشافٍ زمنيةٍ، وتُكبَح تلك التي تُصنَّف على أنها منخفضةُ الموثوقية. ويقوم المُتتبِّعُ، بشكلٍ دوريٍّ، بإعادة تنشيط نفسه باستخدام أقنعةِ الاكتشافِ عاليةِ الثقة، بهدف التعافي من الانحرافات، أو الحجب، أو الالتباس الناتج عن المشاهد المزدحمة. كما يتنبّأ المُتتبِّعُ بثلاثةِ أقنعةٍ مرشَّحةٍ لكلِّ غرضٍ، ويختار القناعَ الأعلى ثقةً لضمان التعامل الأمثل مع حالات عدم اليقين.
علاوةً على ذلك، يُتيح النظامُ للمستخدم، في أيِّ لحظةٍ، تحسينَ قناعٍ أو قناعٍ مصغَّرٍ من خلال نقراتٍ إيجابيةٍ أو سلبيةٍ، بحيث يُنشَر القناعُ المُحسَّنُ بعد ذلك عبر كامل تسلسل الفيديو لضمان دقة التتبّع واستمراريته. [6]
3.3. مقارنة نموذج سام بإصداره الثالث مع نماذج تجزئة أخرى
أولاً: نتائج تجزئة الصور:
|
النموذج |
تجزئة حسب الغرض | كشف مربعات الإحاطة | |||||
| LVIS | SA-Co/Gold | LVIS | COCO | SA-CO/Gold | |||
| cgF1 | AP | cgF1 | cgF1 | AP | AP | cgF1 | |
| الأداء البشري | – | – | 72.8 | – | – | – | 74.0 |
| OWLv2 أولف2 | 29.3 | 43.4 | 24.6 | 30.2 | 45.5 | 46.1 | 24.5 |
| DINO-X داينو-إكس | – | 38.5 | 21.3 | – | 52.4 | 56.0 | 22.5 |
| Gemini 2.5 جيميناي ٢.٥ | 13.4 | – | 13.0 | 16.1 | – | – | 14.4 |
| سام 3 SAM3 | 37.2 | 48.5 | 54.1 | 40.6 | 53.6 | 56.4 | 55.7 |
الجدول (2):مقارنة أداء نماذج الرؤية الحاسوبية في التجزئة الكائنية وكشف مربعات الإحاطة. [8]
تمَّ إجراءُ المقارنة اعتمادًا على مجموعاتِ البياناتِ التالية:
- التجزئةُ الغرضيّةُ ذاتُ المفرداتِ الكبيرة Large Vocabulary Instance Segmentation – LVIS: وهي مجموعةُ بياناتٍ تتميَّز باحتوائها على عددٍ كبيرٍ من الفئات، بما في ذلك الفئاتُ النادرةُ، مما يجعلها معيارًا مهمًّا لاختبار قدرة النماذج على التعميم والتعرّف الدقيق.
- الكائناتُ الشائعةُ في سياقها الطبيعي Common Objects in Context – COCO: تُعَدُّ من أشهرِ مجموعاتِ البياناتِ القياسيةِ في مجال الرؤية الحاسوبية، وتُستخدَم على نطاقٍ واسعٍ لتقييم أداء نماذج الكشف والتجزئة.
- التجزئة الشاملة للمفهوم الدلاليّ Segment Anything – SA-Co/Gold : وهو معيارُ تقييمٍ يعتمد على مجموعةِ عيناتٍ ذهبيةٍ Gold Set لقياس الدقة الواقعية للنماذج في سيناريوهاتٍ متنوعةٍ.
أمّا المقاييسُ القياسيةُ المعتمدةُ في التقييم، فهي:
- متوسطُ الدقة Average Precision – AP: مقياسٌ شاملٌ يُعبِّر عن جودة الأداء من خلال الموازنة بين الدقة وحساسية التنبؤ.
- مقياسُ الدقة–الاسترجاع للأغراض المشتركة Common Ground F1 – cgF1: مقياسٌ يُركِّز على تقييم التوازن بين الدقة والاسترجاع في تحديد الأغراض المشتركة بدقةٍ.
يوضح الجدولُ (2) أنّ نموذجَ “سام 3” SAM3 يتفوَّق على جميع نماذج التجزئة محلِّ المقارنة، سواءٌ في مهام كشف مربعات الإحاطة أم في تجزئة الأغراض. كما تُظهِر النتائجُ أن أداءه يقترب بدرجةٍ ملحوظةٍ من الأداء البشري. [8]
ثانياً: نتائج تجزئة الأغراض في فيديو:
| النموذج | SA-V test | VT-Temporal-1B test | SmartGlasses test | |||
| cgF1 | pHOTA | cgF1 | pHOTA | cgF1 | pHOTA | |
| الأداء البشري | 53.1 | 70.5 | 71.2 | 78.4 | 58.5 | 72.3 |
| سام3 SAM3 | 30.3 | 58.0 | 50.8 | 69.9 | 36.4 | 63.6 |
الجدول(3): مقارنة الأداء البشري و نموذج سام بإصداره الثالث عبر مجموعة من المعايير الاختبارية القياسية. [8]
يوضح الجدول (3) مدى تقارب أداء نموذج “سام 3” SAM3 مع الأداء البشريّ المرجعيّ، وذلك استنادًا إلى مجموعة من المقاييس القياسية المعتمدة في التقييم. فقد تم قياس جودة التوافق بين القناع المتوقع والحقيقة الأرضية Ground Truth باستخدام مقياس مقياسُ الدقة–الاسترجاع للأغراض المشتركة cgF1، إلى جانب استخدام مقياس تتبع الأجسام عبر الزمن Per-frame Higher Order Tracking Accuracy – pHOTAلتقييم كفاءة التتبع عبر الزمن. وتعكس النتائج مستوىً متقدمًا من الدقة والاتساق في أداء النموذج مقارنةً بالمرجع البشري. [8]
يُلاحظ أن النموذج يحقق تحسنًا ملحوظًا في الأداء عند التعامل مع البيانات الزمنية واسعة النطاق VT-Temporal-1B test، في المقابل، يواجه النموذج تحديات أكبر في البيئات الواقعية المعقدة، مثل “سمارت غلاسس” SmartGlasses.
4. دراسة مقارنة لأداء الإصدارات الثلاثة لنموذج التجزئة الشامل SAM
يعرض الجدول (4) مقارنةً كميةً بين نماذج سام بجميع الإصدارات على معيار قياسي “إس إيه -37” SA-37 للتجزئة التفاعلية للصور، حيث يقدّم متوسط مؤشر التقاطع على الاتحاد mIoU تحت أعداد مختلفة من تفاعلات المستخدم، إضافةً إلى سرعة الاستدلال المقاسة بعدد الإطارات في الثانية Frames Per Second – FPS. [9]
| نماذج “سام” SAM | سنة الإصدار | متوسط مؤشر التقاطع على الاتحاد ( نقرة واحدة) | متوسط مؤشر التقاطع على الاتحاد ( 3 نقرات واحدة) | متوسط مؤشر التقاطع على الاتحاد (5 نقرات واحدة) |
عدد الإطارات في الثانية |
|
سام 1 SAM1 |
2023 | 58.5 | 77.0 | 82.1 | 41.0 |
|
سام 2 SAM2 |
2024 | 66.4 | 80.3 | 84.3 | 93.0 |
|
سام 3 SAM3 |
2025 | 66.1 | 81.3 | 85.1 | 43.5 |
الجدول (4): مقارنة نماذج التجزئة الشامل. [9]
تُظهر النتائج تفوقًا واضحًا للإصدارين الثاني والثالث مقارنةً بالإصدار الأول عند عددٍ أقل من نقرات المستخدم. إذ يتصدر “سام2” SAM2 الأداء عند نقرةٍ واحدة، بينما يحقق نموذج “سام 3” SAM3 أفضليةً ملحوظةً عند ثلاث وخمس نقرات، مما يعكس قدرته الأعلى على التحسن مع زيادة التفاعل.
ومن ناحية الكفاءة الحسابية، يُعد نموذج سام 2 SAM2 الأسرع في مرحلة الاستدلال، حيث يسجل أعلى معدل لعدد الإطارات المُعالجة في الثانية الواحدة، وهو ما يبرز ملاءمته للتطبيقات التي تتطلب سرعة معالجة مرتفعة.
5. الإصدارات الأخرى لنماذج سام SAM
يُظهر نموذجا سام موبايل MobileSAM وسام فاستر FasterSAM، رغم كونهما أكثر خفة وكفاءة حسابية، قدرةً عاليةً على الحفاظ على مستوى جيد من الدقة، وذلك لاعتمادهما على البنية الأساسية لنموذج سام SAM. ويؤكد هذا أن النموذج يتمتع بمرونةٍ بنيويّةٍ تمكّنه من التكيّف مع سيناريوهات استخدام متنوعة، دون الحاجة إلى تعديل نمط التفاعل العام. [8]
1-نموذج سام موبايل MobileSAM :
يقدّم النموذج آلية التجزئة المعتمدة على التلقينات إلى بيئات الأجهزة المحمولة والحوسبة الطرفية، من خلال تبسيط التصميم الأصلي لنموذج سام SAM، مع الحفاظ على توافقه مع بنيته التشغيلية الأساسية. ويتيح ذلك تنفيذ مهام التجزئة مباشرةً في البيئات ذات الموارد الحاسوبية المحدودة، مع الاستمرار في إنتاج أقنعة كائنات دقيقة وموثوقة. [9]
وفقًا للشكِل (5)، يُظهر النموذج المعدّل نتائج فعّالة في تجزئة الأغراض مع عدد أقل من المعاملات وبسرعة أعلى، نظرًا لكونه أخف وزنًا مقارنة بالنماذج الأخرى.
| البنية التشغيلية الكاملة (مرمّز + فاكّ الترميز) | نموذج سام الأساسي Original SAM | نموذج سام موبايل MobileSAM |
| عدد المعاملات |
615M |
9.66M |
| السرعة | 456ms | 12ms |
الجدول (5): مقارنة البنية التشغيلية الكاملة. [9]
2- نموذج “سام فاستر” FasterSAM:
يتخذ النموذج مسارًا مختلفًا من خلال اعتماده على هيكلية قائمة على الشبكات العصبية الطيّ المصممة خصيصًا لتقديم تقسيم سريع وفعّال. ويحتفظ بأسلوب التفاعل المعتمد على التلقينات كما هو في نموذج سام SAM، ولكنه مصمم لتوليد الأقنعة بسرعة، مما يجعله مناسبًا تمامًا للتطبيقات التي تتطلب ردودًا بصرية فورية عبر مجموعة واسعة من المهام. [9]
6. الخاتمة
كان نموذج التجزئة الشامل في نسخته الأولى SAM1 يركّز على تجزئة الأغراض في الصور البصرية فقط. ثم عملت شركة “ميتا” على تطوير بنيته التشغيلية بإضافة مكوّنات داخلية متقدمة، مثل مُرمِّز الذاكرة، وبنك الذاكرة، ومُرمِّز الإطارات للفيديو، وآلية اهتمام الذاكرة؛ وذلك لتوسيع نطاق التجزئة ليشمل مقاطع الفيديو، لا الصور الثابتة فحسب ليكون الإصدار الثاني SAM2.
ومع إطلاق الإصدار الثالث SAM3، توسّعت قدرات النموذج لتشمل مدخلات مفاهيميّة دلاليّة، إلى جانب أمثلة صوريّة توضيحيّة، مما يمكّنه من تجزئة جميع الأغراض الواقعة ضمن هذه المفاهيم في أي إطار من إطارات الفيديو من خلال الاعتماد على بنية الكاشف والمتتبع.
كما عملت ميتا على تقديم نماذج أكثر خفة وكفاءة حسابية، تدعم بيئات تشغيلية متنوعة، ولا سيما الأجهزة المحمولة، مثل سام موبايل MobileSAM وسام فاستر FasterSAM، مع الحفاظ على الفلسفة المعمارية الأساسية للنموذج الأصلي.
7. المراجع
- Segment Anything 2: What Is the Secret Sauce? (A Deep Learner’s Guide) | medium
- arXiv:2408.00714v2 [cs.CV] 28 Oct 2024
- SAM2 | meta
- arXiv:2511.16719v1
- Inside SAM 3: The Next Generation of Meta’s Segment Anything Model | medium
- Paper Review: SAM 3: Segment Anything with Concepts | medium
- ٍSAM3 | meta
- SAM3 | github
- Complete Guide to SAM Models: Architecture, Performance Comparison & Use Cases