رابط الورقة البحثيّة:
End-to-End Agentic RAG System Training for Traceable Diagnostic Reasoning
إعداد: م. نادية عبد الجواد
التدقيق العلميّ و اللغوي: م. ماريّا حماده
1. المقدّمة
تستعرض هذه الورقة البحثيّة، الموسومة بعنوان “End-to-End Agentic RAG System Training for Traceable Diagnostic Reasoning”، نظامًا تشخيصيًّا قائمًا على الوكلاء “Deep-DxSearch ” يحاكي السّلوك التّكراري للأطباء في البحث عن المعلومات، متجاوزًا نمط الإجابة المباشرة عن الأسئلة إلى دور باحثٍ نشطٍ قادرٍ على الاستقصاء، وجمع الأدلّة، وتقييمها، وبناء استنتاجٍ تشخيصيٍّ قابلٍ للتّتبّع. ويعتمد النّظام على التّعلّم المعزَّز Reinforcement Learning – RL لتعلّم متى يبحث، وما الّذي يبحث عنه، وكيف يُعيد توجيه مسار البحث بناءً على الأدلّة الّتي يحصل عليها.
2. مشكلة البحث
تواجه النّماذج اللّغويّة الكبيرة LLMs قيودًا جوهريّةً في التّشخيص الطّبيّ، إذ قد تولّد معلوماتٍ غير دقيقةٍ نتيجة الهلوسة، ممّا يستلزم دعم الاستنتاجات التّشخيصيّة بأدلّةٍ سريريّةٍ موثوقةٍ وقابلةٍ للتّحقق. ورغم أنّ التّوليد المعزَّز بالاسترجاع RAG يساهم في الحدّ من هذه المشكلة، فإنّ أنظمته الحالية تعتمد غالبًا على سير عملٍ ثابتٍ قائمٍ على قواعد إرشاديّة، ولا تحاكي بصورةٍ كافيةٍ طبيعة الاستدلال السّريري التّكراري القائم على الفرضيّات والأدلّة الّذي يتبعه الخبراء السّريريّون.
3. الثّغرة البحثيّة
تتمثّل الثّغرة البحثيّة في النّقاط التّالية:
- في المجال الطّبيّ التّشخيصيّ، لا تقتصر موثوقيّة القرار على الوصول إلى التّنبؤ الصّحيح، بل تتطلّب إثبات الفرضيّات بالأدلّة السّريريّة، والسّوابق الطّبيّة، والأدبيّات العلميّة الموثوقة، وهو أحد المبادئ الأساسيّة للطّبّ القائم على الدّليل Evidence-Based Medicine- EBM.
- ظهر التّوليد المعزَّز بالاسترجاع Retrieval-Augmented Generation- RAG لربط النّماذج اللّغويّة الكبيرة بمصادر خارجيّة، وتمكينها من الوصول إلى معلوماتٍ حديثةٍ دون الحاجة إلى إعادة تدريب النّموذج. إلّا أنّ أنظمته الطّبيّة الحالية تعتمد غالبًا على استرجاعٍ ثابتٍ أو أحادي الجولة، بحيث لا تعيد تقييم استراتيجيّة البحث عند عدم كفاية الأدلّة أو عدم موثوقيّتها أو تعارضها، ممّا يتناقض مع النّهج الدّيناميكي والتّكراري الّذي يتبعه الطّبيب؛ إذ يبدأ بتشخيصٍ تفريقي، ثمّ يتحقّق من الأعراض، ويراجع الإرشادات والحالات السّابقة، ويعيد تقييم فرضيّاته استنادًا إلى المعلومات الجديدة، ويواصل البحث عند وجود الغموض حتّى يصل إلى استنتاجٍ أكثر اتساقًا وموثوقيّة.
- تفتقر هذه الأنظمة إلى القدرة ما وراء المعرفيّة Meta-Cognitive Ability الّتي تمكّنها من إدراك حالة عدم اليقين وتحديد المعلومات النّاقصة، ثمّ البحث عنها بصورةٍ نشطةٍ لاستكمال الحلقة التّشخيصيّة.
4. المعماريّة المستخدمة
أوّلًا: إعداد البيانات
جُمعت البيانات السّريرية والمعرفيّة من سبعة مصادر رئيسيّة، وشملت حالات لأمراضٍ شائعةٍ ونادرةٍ. خضعت البيانات لمراحل متتابعة من التّصنيف، والتّصفية المسبقة، واستخراج التّشخيصات والأنماط الظّاهريّة، وتوحيد المصطلحات الطّبيّة، والتّحقق اليدويّ لضمان جودتها ومنع تسرّب المعلومات. وبُني Medical Retrieval Corpus من قاعدة استرجاعٍ شاملةٍ تتكوّن من ثلاثة مصادر معرفيّة رئيسيّة:
-
إرشاداتٌ مرضيّةٌ منظَّمةٌ تربط أكثر من 250 ألف زوجٍ من المرض–النّمط الظّاهري بالمصطلحات الطّبيّة المعياريّة.
-
قاعدة بياناتٍ لسجلات المرضى تضمّ 155 ألف حالةٍ سريريّةٍ موثَّقة لاسترجاع الحالات المشابهة.
-
مستودعٌ معرفيٌّ سريريٌّ واسعٍ يضمّ ملايين المقالات الطّبيّة من PubMed ووثائق Wikipedia لتوفير سياقٍ دلاليٍّ شامل.
كما أُعدّت مجموعة تدريبٍ وتقييمٍ تضمّ 24,142 حالةً سريريّةً تغطي أكثر من 3,000 مرضٍ، منها 73.1% أمراضٌ شائعةٌ و26.9% أمراض نادرة. وقُسّمت خمس مجموعات بياناتٍ بنسبة 3:1 للتّدريب والتّقييم، بينما خُصّصت مجموعتا Mendeley وXinhua-Rare لتقييم الاختبار خارج التّوزيع OOD Zero-Shot وقياس قدرة النّموذج على التّعميم على مصادر غير مرئيّة.
ثانياً: إطار عمل Agentic RAG
يهدف النّموذج إلى توليد مسارٍ تشخيصيٍّ دقيقٍ ومدعومٍ بالأدلّة الصّحيحة، ويتكوّن من مكوّنين رئيسيّين: وكيلٌ قائمٌ على نموذجٍ لغويٍّ كبيرٍ LLM-based Agent لاتخاذ قراراتٍ تشخيصيّةٍ متتابعةٍ، وبيئةٌ خارجيّةٌ تمثّل قاعدة المعرفة الطّبيّة الّتي تتضمّن إرشادات الأمراض والسّجلات المرضيّة وغيرها من المعارف الطّبيّة.
لمحاكاة عمليّة التّشخيص السّريري، يمتلك الوكيل خمس عمليّات أساسيّة:
-
Reason: تحليل الأدلّة وتحديث الفرضيّات التّشخيصيّة.
-
Diagnose: إصدار التّشخيص النّهائي.
-
Lookup: البحث في إرشادات ومعلومات الأمراض.
-
Match: استرجاع حالاتٍ مشابهةٍ اعتمادًا على الأنماط الظّاهريّة.
-
Search: البحث الحرّ عن المعرفة الطّبيّة العامّة.
يعمل الوكيل ضمن مسارٍ تفاعليٍّ وتكراريٍّ؛ إذ يقيّم المعلومات المتاحة في كلّ خطوةٍ، ثمّ يختار الإجراء الأنسب، سواءً كان الاستدلال، أو البحث، أو استرجاع حالاتٍ مشابهةٍ، أو إصدار التّشخيص النّهائي. وعند استخدام أدوات الاسترجاع، تعيد البيئة النّتائج إلى الوكيل ليحدّث مسار استدلاله ويواصل الخطوة التّالية.
وتُعبّر المعادلة:
St=St−1∪{at,ft}
عن تحديث الحالة في كلّ خطوةٍ؛ إذ تتكوّن الحالة الجديدة St من الحالة السّابقة St−1، الّتي تشمل الأعراض والتّاريخ المرضيّ ونتائج الفحوصات والإجراءات السّابقة ونتائجها، مضافًا إليها الإجراء الجديد الّذي اتخذه الوكيل at والنّتيجة أو المعلومة الّتي حصل عليها ft.
ثالثاً: آليّة المكافأة Reward Mechanism
اعتمد الباحثون دالّة مكافأةٍ مركّبةٍ لتوجيه الوكيل نحو الدّقّة، والاتّساق، والتّنوّع، وجودة جمع الأدلّة، بحيث لا تقتصر المكافأة على صحّة التّشخيص النّهائيّ، بل تشمل أيضًا المسار التّشخيصيّ المتّبع للوصول إليه.
وتتكوّن من أربعة مكوّناتٍ رئيسيّةٍ:
-
الالتزام بالتّنسيق (Format Alignment – σf): مكافأة التزام الوكيل ببنية الإخراج والبروتوكول المحدّد، وأيّ مخالفةٍ تُلغي مكافأة المسار.
-
تنوّع المسار (Trajectory Exploration – σdiv): الحدّ من تكرار المسارات التّشخيصيّة وتشجيع استكشاف مساراتٍ مختلفةٍ.
-
جمع الأدلّة (Evidence Acquisition): ويشمل مطابقة الحالات (Patient Matching – σm) لاسترجاع حالاتٍ مشابهةٍ ذات تشخيصٍ صحيحٍ، تُفرض عقوبات على كثرة عمليّات المطابقة غير الفعّالة، كما يُشترط أن تختلف الاستعلامات المتتالية في الأعراض المستخدمة فيها، لضمان أن يكون كلّ بحثٍ موجّهًا نحو اكتشاف أدلّةٍ جديدةٍ، وصلة البحث (Search Relevance – σs) تهدف إلى تعليم الوكيل صياغة استعلامات بحثٍ مفيدةٍ ومرتبطةٍ بـ التّشخيصات المحتملة، بحيث يحصل على مكافأةٍ حتّى عند العثور على معلوماتٍ جزئيّةٍ أو مرشّحات تشخيصيّةٍ ذات صلة، وليس فقط عند الوصول المباشر إلى التّشخيص الصّحيح.
-
دقّة التّشخيص (Diagnostic Accuracy – σd): تقييم مدى صحّة التّشخيص النّهائيّ مقارنةً بالتّشخيص المرجعيّ.
وتُحسب المكافأة الكلّية وفق المعادلة التّالية:
σtotal = clip[0, 1] [σf · σdiv · (wmσm + wsσs + wdσd)]
حيث تجمع σtotal مكوّنات المكافأة المختلفة بأوزانٍ محدّدةٍ، ثمّ تُحصر قيمتها بين 0 و1.
رابعاً: تدريب النّموذج
يتكوّن تدريب النّموذج من عدّة مراحل مترابطة:
-
تدريب الوكيل والتّفاعل مع البيئة Interleaved Agent-Environment Rollout
دُرِّب الوكيل من خلال تفاعلٍ متداخلٍ ومستمرٍّ بين الوكيل والبيئة. فعند استدعاء إحدى أدوات الاسترجاع، مثل Lookup، يتوقّف الوكيل مؤقّتًا لإرسال الاستعلام إلى مصادر المعرفة الخارجيّة، مثل Wikipedia وPubMed والإرشادات الطّبيّة. ثمّ يُستخدم نموذج Qwen-3-235B لتلخيص المعلومات المسترجعة، وإدراجها في سياق الوكيل. -
تحسين سياسة الوكيل باستخدام GRPO
بعد ذلك، جرى تحسين سياسة الوكيل باستخدام Group Relative Policy Optimization -GRPO، الّذي يقارن مجموعةً من المخرجات ويعتمد على المكافآت النّسبيّة لتوجيه النّموذج نحو مساراتٍ تشخيصيّةٍ أكثر دقّةً وفاعليّةً، بدل الاكتفاء بتحسين النّتيجة النّهائيّة وحدها. -
التّكيّف متعدّد المراحل للمكافأة Multi-stage Reward Adaptation
ولرفع كفاءة التّدريب، اعتمد الباحثون استراتيجيّةً تدريجيّةً لتحسين أهداف المكافأة، إذ أظهر تحسين جميع الأهداف في آنٍ واحدٍ كفاءةً أقل. لذلك، نُفِّذ التّدريب على ثلاث مراحل متتابعة، ركّزت على صلة البحث (σs)، ثمّ مطابقة الحالات (σm)، ثمّ دقّة التّشخيص (σd). وفي المرحلة الرابعة، دُمجت هذه الأهداف معًا بأوزانٍ متوازنةٍ لتحقيق تدريبٍ مشتركٍ أكثر تكاملًا.
وأظهرت النّتائج أنّ التّركيز على مكافأة مطابقة الحالات خلال المراحل الوسيطة أسهم في تحقيق تحسّنٍ أكبر في دقّة التّشخيص النّهائيّة مقارنةً بالتّركيز المباشر على مكافأة التّشخيص النّهائي وحدها.
5. النّتائج التّجريبيّة
1.5.التّقييم الشّامل لأداء Deep-DxSearch والعوامل المؤثّرة في تفوقه التّشخيصيّ
- اعتمد الباحثون نموذج MedGemma-27B بوصفه النّموذج الأساسي لبناء نظام Deep-DxSearch، وقيّموا دقته التّشخيصيّة من خلال مقارنة منهجيّته مع نماذج لغويّة عامّة ومتخصّصة وأساليب طبيّة متقدّمة، من بينها GPT-4o وDeepSeek-R1 وMedRAG وMAC، عبر بياناتٍ متعدّدة المراكز تشمل الأمراض الشّائعة والنّادرة.
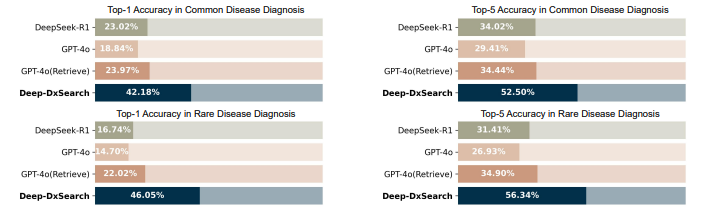
ففي بيانات التّوزيع الدّاخليّ In-distribution -ID (الشّكل (1))، حقّق النّظام متوسط دقة Top-1 بلغت 42.2% في تشخيص الأمراض الشّائعة، و52.5% في تشخيص الأمراض النّادرة، متفوّقًا بوضوحٍ على النّماذج المرجعيّة.
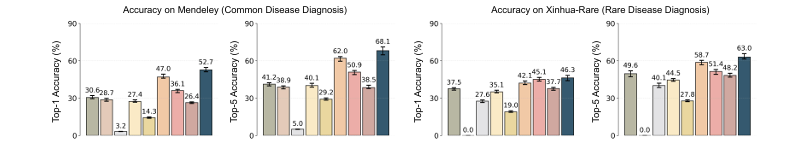
كما أظهر صلابةً وقدرةً قويّةً على التّعميم في بيانات التّوزيع الخارجي Out-of-distribution -OOD (الشّكل (2))، محققًا دقة Top-1 بلغت 52.7% على معيار Mendeley و46.3% على Xinhua-Rare، متفوقًا على الأساليب المنافسة. وتشير هذه النّتائج إلى أنّ أنماط الاستدلال الوكيلي المكتسبة عبر التّعلّم المعزّز تنتقل بفاعليّة إلى بيئاتٍ سريريّةٍ جديدةٍ، بما يعزّز قابليّة التّعميم والأداء التّشخيصيّ.
- ولتحليل أسباب تفوّق Deep-DxSearch، درس الباحثون أثر التّدريب الشّامل بالتّعلّم المعزّز Reinforcement Learning، من خلال مقارنته بنماذج LLM الأساسيّة (Vanilla)، وأساليب RAG، والضّبط الدّقيق الخاضع للإشراف Supervised Fine-Tuning -SFT، وعبر نماذج أساسيّة متعدّدة. وأظهرت النّتائج تفوّق النّظام بصورةٍ متّسقة؛ فعلى سبيل المثال، حقق 49.3% عند استخدام Qwen-7B على مجموعة MedDialog، و39.3% Top-1 عند استخدام Baichuan-M2 على Xinhua-Rare، متجاوزًا النّماذج والأساليب المرجعيّة. كما أظهر التّدريب القائم على التّعلّم المعزّز قدرةً أفضل على الحدّ من مشكلة فرط التّكيّف Overfitting المرتبطة بـ SFT، مع الحفاظ على أداءٍ قويٍّ في بيانات التّوزيع الخارجيّ OOD، إضافةً إلى تحسين جودة الاستدلال وتقليل شدّة الهلوسة.
2.5. تحليل مكوّنات Deep-DxSearch وتطوّر سياسة الاستدلال التّشخيصي
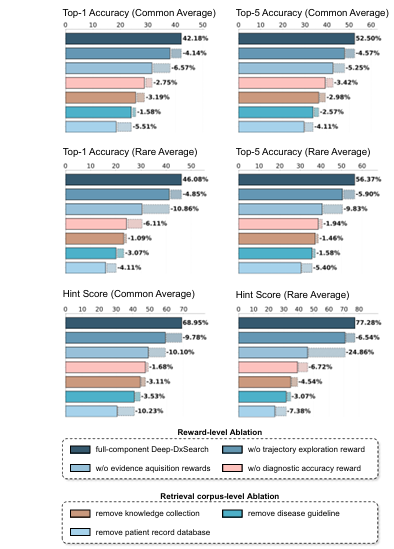
- كشفت دراسة الإزالة (الشّكل(3)) أنّ آليّة اكتساب الأدلّة evidence acquisition الخاصّة بالمكافأت تمثّل أحد المكونات الجوهريّة في أداء النّظام؛ إذ أدّى استبعادها إلى انخفاض الدّقة بنسبة 6.6% في الأمراض الشّائعة و10.9% في الأمراض النّادرة، ممّا يبرز أهميّة التّكامل بين استرجاع المعلومات (حالاتٍ مشابهةٍ وتشخيصاتٍ محتملةٍ مشابهةٍ) وتحليلها ضمن عمليّة التّشخيص.
- كما أظهرت دراسة الإزالة (الشّكل(3)) أنّ مطابقة سجلات المرضى excluding patient record matching بالحالات السّريريّة المتشابهة تمثّل المكوّن الأكثر تأثيرًا ضمن قاعدة الاسترجاع؛ إذ أدّى استبعاد هذه الآليّة إلى انخفاض الدّقة بنسبة 5.5% في الأمراض الشّائعة و4.1% في الأمراض النّادرة. وتؤكد هذه النّتيجة أنّ الاسترجاع القائم على الأدلّة والسّياق السّريري يشكّل ركيزةً أساسيّةً لتحسين دقّة التّشخيص.
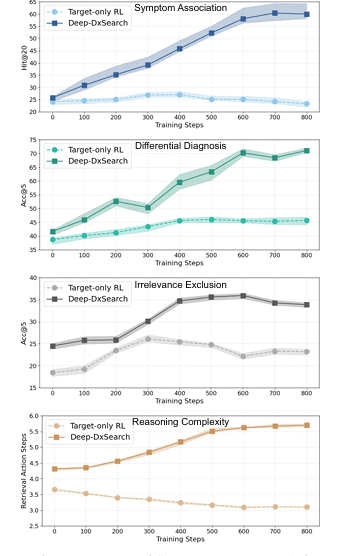
- أظهر تحليل تطوّر السّياسة التّشخيصيّة (الشّكل (4)) تفوّق Deep-DxSearch على خطّ الأساس Target-only RL، الّذي يعتمد على مكافأة النّتيجة النّهائيّة فقط، ممّا يعكس قدرة النّظام على تعلّم استراتيجيّات بحثٍ واستدلالٍ أكثر فاعليّة. فقد ارتفعت قيمة Hit@20 في مهمّة ارتباط الأعراض Symptom Association من 25.8% إلى 60.4%، ممّا يدلّ على تحسن قدرة النّموذج على ربط الأعراض بالحالات ذات الصّلة واسترجاع المعلومات المناسبة. كما ارتفعت دقّة التّشخيص التقّفريقي Differential Diagnosis، حيث بلغ Acc@5 لـ Deep-DxSearch نحو 71.1%، مقارنةً بـ45.8% لخطّ الأساس Target-only RL، ممّا يعكس تحسن قدرة النّظام على تحديد التّشخيص الصّحيح ضمن البدائل التّشخيصيّة المحتملة. بما يعكس تحسّن قدرته على تضييق نطاق التّشخيص التّفريقي. كذلك أظهر النّظام زيادةً في الدّقة بلغت 10% عند إدخال مستنداتٍ غير ذات صلةٍ أثناء الاختبار، بما يشير إلى قدرته على مقاومة ضوضاء المعلومات. ومع ارتفاع متوسط طول مسار الاستدلال إلى أكثر من 5.5 خطواتٍ في الحالات ذات التّعقيد الاستدلالي، يتضح أنّ النّظام تعلّم تنفيذ مسارات بحثٍ واستدلالٍ أكثر عمقًا وتكيّفًا مع تعقيد الحالة السّريريّة.
3.5. تقييم أداء Deep-DxSearch كأداةٍ شفّافةٍ لدعم اتّخاذ القرار السّريريّ من قِبَل الأطبّاء
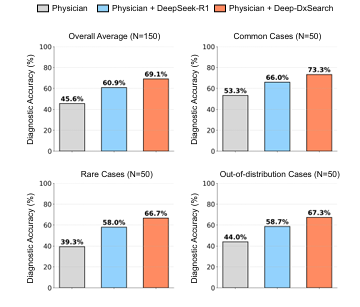
- أظهر التّقييم السّريري بمشاركة الأطبّاء (الشّكل (5)) فاعليّة Deep-DxSearch في تعزيز دقّة التّشخيص؛ إذ ارتفع متوسّط دقّة تشخيص الأطبّاء إلى 69.1%، مقارنةً بـ 45.6% في غياب أيّ مساعدةٍ بالذّكاء الإصطناعيّ، و60.9% عند استخدام DeepSeek-R1. وفي الحالات خارج التّوزيع (OOD)، حقّق الأطبّاء بمساعدة Deep-DxSearch دقّة بلغت 67.3%، مقابل 44.0% دون مساعدة و58.7% عند استخدام DeepSeek-R1.
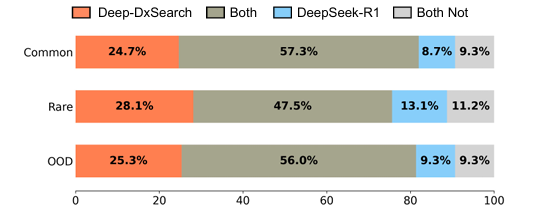
- وفي تقييم تفضيلات الأطبّاء للنّظام المقترح مقارنةً بالنّموذج المرجعي (الشّكل (6))، جرى تقييم أداء Deep-DxSearch وDeepSeek-R1، إلى جانب حالة عدم استخدام أيّ أداةٍ ذكيّةٍ مساعدةٍ عبر مجموعات بيانات الأمراض الشّائعة والنّادرة وخارج التّوزيع (OOD). وأظهرت النّتائج تفضيلًا واضحًا وقويًّا لـ Deep-DxSearch من قِبَل الأطبّاء عبر مختلف أنواع البيانات، بما يعكس تفوّقه من حيث القيمة العمليّة لدعم الاستدلال والتّشخيص السّريريّ.
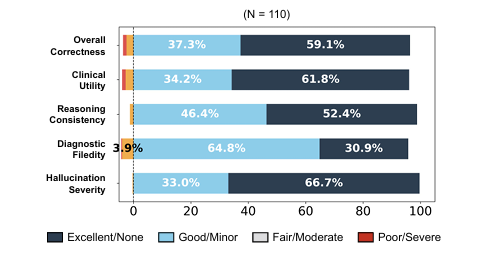
- وأظهر التّقييم البشريّ الشّامل (الشكل (7)) أداءً إيجابيًّا لـ Deep-DxSearch عبر ثلاثة أبعاد رئيسيّة: صحّة التّشخيص، والمنفعة السّريرية، وشدّة الهلوسة. ففي تحليل 110 عيّنات، صُنِّفت 59.1% من التّقييمات ضمن أعلى فئةٍ لصحّة النّتائج التّشخيصيّة، و61.8% ضمن أعلى فئةٍ للمنفعة السّريريّة، في حين صُنِّفت 66.7% ضمن أعلى فئةٍ تقييمًا لمستوى الهلوسة، ممّا يشير إلى مستوى مرتفع من موثوقيّة المخرجات وقابليّتها للاستخدام السّريريّ.
4.5. تحليل أنماط الفشل التّشخيصيّ وحدود النّموذج
كشف تحليل 216 حالة فشلٍ عن أنماط مختلفة للأخطاء؛ إذ تمحورت إخفاقات تشخيص الأمراض الشّائعة حول غموض المدخلات ومشكلات استرجاع المعلومات، بينما تمحورت إخفاقات الأمراض النّادرة حول قصور الاستراتيجيّة التّشخيصيّة والاستدلال، خاصّةً الإغلاق التّشخيصيّ المبكر وفشل التّشخيص التّفريقي. وتؤكد هذه النّتائج ضرورة تحسين جودة الاسترجاع وتعزيز قدرات الاستدلال السّريري.
6. الخلاصة
قدّمت الدّراسة نظام Deep-DxSearch، وهو نظامٌ تشخيصيٌّ مدعومٌ بالتّوليد المُعزَّز بالاسترجاع القائم على الوكلاء، يدرّب الوكيل الذّكي على محاكاة مسارات التّشخيص السّريري من خلال خمس مراحل متكرّرة وديناميكيّة. كما يعتمد النّظام على نظام مكافآتٍ يركّز بصورةٍ أساسيّةٍ على استكشاف مساراتٍ تشخيصيّةٍ متنوّعةٍ، ودقّة مطابقة الحالات السّريريّة المشابهة للحالة الحاليّة، مع تحقيق ذلك بأقلّ عددٍ ممكنٍ من محاولات الاسترجاع، إلى جانب تحسين كفاءة عمليّة البحث ودقة الاستدلال التّشخيصيّ.
أظهر النّظام كفاءةً عاليةً في استرجاع الأدلّة، ولا سيّما من خلال الاستفادة من سجلات المرضى ذوي الحالات المشابهة، وهو ما عزّز دقّة مسار التّشخيص وتضييق نطاق الاحتمالات التّشخيصيّة البديلة. وقد أظهر النّظام تفوّقًا على النّماذج المنافسة، ولا سيّما في تشخيص الأمراض النّادرة، إلى جانب تعزيز الدّقّة في الاستدلال التّشخيصيّ والشّفافيّة والفائدة السّريريّة في التّعاون بين الطّبيب والذّكاء الإصطناعيّ.
وتتمثّل أبرز القيود في فجوات قاعدة المعرفة، والاعتماد على البيانات النّصيّة فقط، واستمرار بعض أخطاء الاستدلال والهلوسة، ممّا يوجّه العمل المستقبليّ نحو تحديث المعرفة باستمرار ودعم البيانات متعدّدة الوسائط وتحسين موثوقيّة الاستدلال.
7. الملحق
يتضمّن هذا القسم الجداول الخاصّة بالنّتائج التّجريبيّة لتقييم النّماذج الإصدار الرّابع من نموذج Deep-DxSearch.