إعداد: م. ماريّا حماده
التّدقيق العلميّ: م. نادية عبد الجواد
مصدر الورقة البحثيّة:
https://www.sciencedirect.com/science/article/pii/S1110016824011591#sec0020
1. المقدّمة
تستعرض هذه الورقة البحثيّة الموسومة بعنوان: “Early detection of sepsis using machine learning algorithms” الإسهامات الفعّالة والمفيدة المرتبطة بالكشف المبكر عن حالة تعفّن/تسمّم الدّم (sepsis) على مستوى المريض والكادر الطّبيّ على حدٍّ سواء، بالإضافة إلى إمكانيّة توظيف خوارزميّات تعلّم الآلة للكشف عنه والتّنبؤ ببدايته خصوصًا عند الأشخاص المعرّضين للخطر والّذين من المحتمل أن تتطوّر الحالة لديهم إلى صدمةٍ إنتانيّةٍ (septic shock) قاتلة.
2. مشكلة البحث
يُعرف تسمّم الدّم بأنّه ردّ فعلٍ مناعيٍّ شديدٍ تجاه الالتهابات والميكروبات الممرضة، حيث تؤدي هذه الحالة الطّبيّة الخطيرة إلى حدوث صدمةٍ إنتانيّةٍ وفشلٍ في الأعضاء الحيويّة في الجسم وأذيّةٍ بأنسجته ممّا يزيد من معدّل الوفاة به. ويعدّ اكتشافه مبكرًا تحديًا سريريًّا وبالأخصّ لكونه شائعًا جدًّا بين الأطفال؛ هذا ما خلق حاجةً ملحة لضرورة إجراء تدخلاتٍ طبيّةٍ فوريّةٍ وإنشاء إطارٍ تنبؤيٍّ فعّال قادرٍ على معالجة أوجه القصور في الأساليب الحاليّة من جهة والكشف بدقة عن العلامات والتطوّرات الخطيرة المرتبطة بالإنتان من جهةٍ أخرى، فضلًا عن مساعدته لمتخصّصي الرّعاية الصّحيّة في وحدات العناية المركزة (ICUs=Intensive Care Units) وأقسام الطّوارئ باتّخاذ قراراتٍ طبّيّةٍ دقيقةٍ وحاسمةٍ ومدروسةٍ تسهم بتحسين جودة الرّعاية الطّبيّة المقدّمة للمرضى وبالتّالي تحقيق نتائج علاج أفضل على المدى البعيد.
3. الثّغرة البحثيّة
يتركز لبّ الدّراسة حول تغطية النّقص المعرفيّ المتمثّل بغياب استراتيجيّات وأدوات تشخيص فعّالة في التّعرّف المبكر على الإنتان قادرةٍ على تمثيل الطّبيعة المعقدة ومتعددّة الأبعاد له ورصد أيّ تغيّرٍ ديناميكيٍّ يطرأ على الحالة الصّحيّة للمريض مع مرور الوقت.
4. مجموعة البيانات المستخدمة
تمّ استخدام مجموعة البيانات (PhysioNet competition 2019) والّتي تتضمّن بيانات طبيّة أُخذت لمرضى خلال فترة تواجدهم في وحدات (ICUs) وبشكلٍ ساعيٍّ. وقد شملت هذه المجموعة على 40 سمة وزّعت وفق عدّة أنواع: المعلومات الدّيموغرافيّة للمريض والعلامات الفسيولوجيّة له والفحوصات المخبريّة الخاصّة به والّتي شكلت بمجملها السّجل الطّبيّ الإلكترونيّ للمريض (EMR=Electronic Medical Records)، حيث أُجري على بياناته العديد من خطوات المعالجة المسبقة من أجل زيادة فعاليّة البيانات قبل تغذية النّموذج المقترح بها، نذكر منها:
- التّعامل مع البيانات المفقودة: من خلال طرق استكمال البيانات (imputation techniques) كحساب قيمة المتوسط (mean) أو العدد الأوسط (median) أو العدد الأكثر تكرار (mode) ضمن السّمة الواحدة.
- توحيد قيم السّمات ضمن مقياس واحد: من خلال استخدام التّطبيع (normalization) الّذي يجعل قيم البيانات تتراوح بين 0 و 1، أو التّقييس (standardization) الّذي يجعل البيانات تمتلك توزيع طبيعي/غوصي.
- تقليل الأبعاد: من خلال خوارزميّة تحليل المكوّنات الرّئيسيّة (PCA=Principal Component Analysis) والّتي تضمن تقليل الأبعاد مع الاحتفاظ بأكبر قدرٍ ممكنٍ من التّباين (variance) في البيانات، أو خوارزميّة التّحليل التّمييزي الخطي (Linear Discriminant Analysis) والّتي تضمن أيضًا تقليل الأبعاد ولكن مع التّركيز على جعل أصناف البيانات منفصلة ومتباعدة عن بعضها البعض قدر الإمكان.
5. المعماريّة المستخدمة
من الطّبيعي أنّ ارتفاع حالات العدوى المقاومة للأدوية أن يؤدي لارتفاع حالات الإنتان المميتة في المقابل، لذلك اعتمد باحثو هذه الدّراسة على توظيف آلة المتجه الدّاعم القائمة على تعلّم الآلة (Machine Learning based-Support Vector Machine=ML-SVM) في منهجيّتهم المقترحة من أجل تغطية عدّة جوانب من خلالها، مثل:
- تحليل المعلومات وتزويد الأطباء بأداةٍ موثوقةٍ لتشخيص الإنتان.
- المساعدة في اتخاذ الإجراءات والتّدابير الوقائيّة والعلاجيّة.
- التّقليل من معدّلات الإصابة والوفيّات بالإنتان.
- جعل نتائج التشخيص أكثر قابليّة للتّفسير.
- التّعامل مع البيانات ذات المتغيّرات الدّيناميكيّة ومتعدّدة الأبعاد.
تعمل هذه الخوارزميّة على إيجاد أفضل حدًّ فاصلٍ بين الفئات المحدّدة مسبقًا: (sepsis=+1) و (non-sepsis=-1) بحيث يعطي أكبر هامش ممكن (أي عرض المسافة الفاصلة بين الفئتين وحول الخط). وفي حال كون البيانات غير خطّية، يتمّ اللّجوء لاستخدام نواة (kernel) لتحويل تمثيل البيانات من فضاء منخفض الأبعاد إلى أعلى منه للفصل بينها بواسطة (hyperplane) خطي ضمن فضاء الأبعاد الجديد.
6. النّتائج التّجريبيّة
تمّ مناقشة النّتائج البحثيّة من عدّة جوانب لإبراز مدى فعاليّة وموثوقيّة النّموذج المقترح وقدرته في التّمييز بين الأشخاص (sepsis) و (non-sepsis) وفق ما يلي:
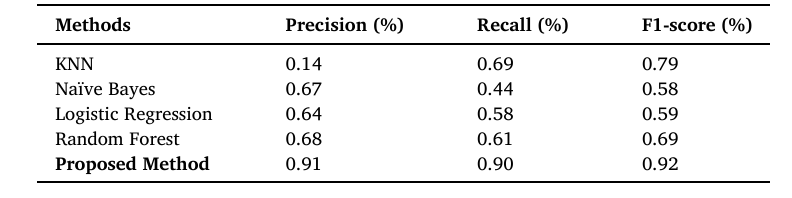
- تقييم الأداء مقارنةً باستراتيجيّات التّصنيف الحاليّة للأشخاص المصابين بالإنتان (الجدول1).
تمّ إجراء تقييم شامل لأداء الطّريقة المقترحة (ML-SVM) مع عدّة خوارزميّات لتعلّم الآلة وهي: (KNN/Naïve Bayes/Logistic Regression/Random Forest) وفق معايير التّقييم (Precision/Recall/F1-score)، وما تشير إليه قيم هذا الجدول هو تفوّق (ML-SVM) بشكلٍ ملحوظ على الطّرق التّقليديّة؛ ما يجعله أداةً فعّالة ومرنة في تشخيص حالات الإنتان بدقة في البيئات الطّبيّة.
أيضًا أظهرت الخوارزميّة قيمة (sensitivity) عالية في تحديد النّتائج الإيجابيّة الحقيقيّة (مرضى الإنتان) والمفيدة في إجراء تشخيصٍ سريعٍ للإنتان لدى الأشخاص المعرّضين للخطر في الواقع.
كما وأظهرت قيمة ملحوظة في (specificity)، ممّا يدلّ على قدرة النّموذج في تحديد الحالات السّليمة الحقيقيّة بدقة مع التّقليل من التّنبؤات الإيجابيّة الخاطئة أي (FP).
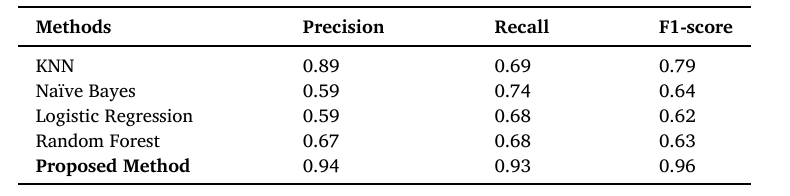
- تقييم الأداء مقارنةً باستراتيجيّات التّصنيف الحاليّة للأشخاص غير المصابين بالإنتان (الجدول2).
تمّ إجراء تقييم شامل لأداء الطّريقة المقترحة (ML-SVM) مع عدّة خوارزميّات لتعلّم الآلة وهي: (KNN/Naïve Bayes/Logistic Regression/Random Forest) وفق معايير التّقييم (Precision/Recall/F1-score)، وما تشير إليه قيم هذا الجدول هو أنّ خوارزميّة (KNN) أعطت أعلى قيمة (F1-score) من بين جميع المصنّفات الأخرى التّقليديّة، حيث بلغت حوالي (0.79). في حين أظهرت الخوارزميّة المقترحة أداءً استثنائيًّا في هذا السّياق وفق جميع معايير التّقييم المقدّمة، بالإضافة لقدرتها الفائقة في الكشف عن الأفراد غير المصابين بتعفن الدّم، ممّا يساعد في تجنّب الإجراءات والعلاجات الطّبيّة غير الضّروريّة وبالتّالي الحدّ من استهلاك موارد إضافيّة.
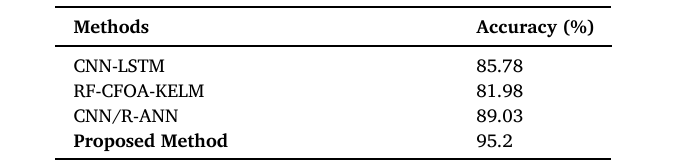
- تقييم دقّة (ML-SVM) بدقة أساليب الكشف عن الإنتان الحاليّة (الجدول3).
تمّ فيها إجراء مقارنة للنّهج المقترح مع أحدث الخوارزميّات المستخدمة حاليًّا في تشخيص الإنتان (CNN-LSTM/ RF-CFOA-KELM/CNN/R-ANN) من خلال احتساب دقة الأداء، حيث بلغت حوالي (95.2%) في (ML-SVM) والّذي تفوّق على نظرائه في الكشف بدقة عن مرضى الإنتان والتّنبؤ الفعّال ببدايته.
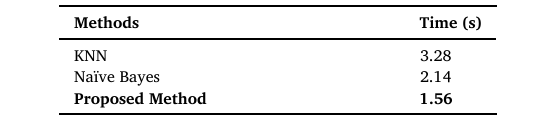
- تقييم أداء وعمل النّموذج المقترح وفق زمن الحوسبة المستغرق (الجدول4).
أظهرت المقارنة بين زمن الحوسبة لكلٍّ من طريقة (ML-SVM) وخوارزميّتي (KNN) و (Naïve Bayes) تفوّقًا واضحًا، حيث حصد النّهج المقترح حوالي (1.56s) مقابل (3.28s) و (2.14s) لكلٍّ من الخوارزميّتين على التّوالي. ما يجعل هذا الوقت المستغرق يعزّز من ملاءمة النّموذج ضمن البيئات الّتي تكون فيها التّنبؤات الفوريّة الصّحيحة بالإنتان أو اتخاذ قراراتٍ سريعةٍ ودقيقةٍ أمرًا ملحًا وضروريًّا.
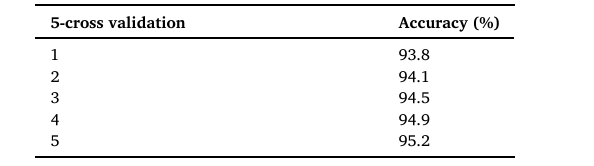
- تقييم أداء النّموذج المقترح وفق التّحقق المتقاطع (الجدول5).
يتمّ تطبيق (5 fold cross-validation) للتّحقق من موثوقيّة نتائج الدّراسة، حيث تراوحت الدّقة ما بين (93.8%) في التّجربة الأولى وصولًا إلى (95.2%) في التّجربة الخامسة والأخيرة، ممّا يدلّ على متانة النّموذج واستقرار أدائه وموثوقيّته في التّنبؤ ببداية الإنتان بدقة عبر التّقسيمات المختلفة لمجموعة البيانات.
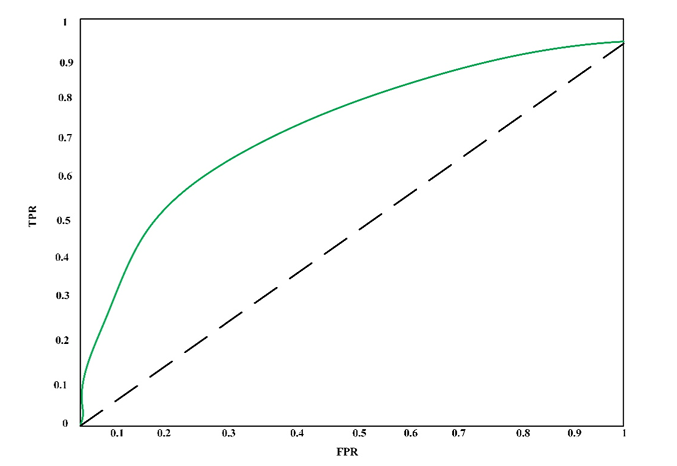
- تقييم الأداء وفق منحنى (ROC) (الشّكل1).
يمثّل هذا المنحنى قدرة النّموذج فعليًّا على التّمييز بين حالات (sepsis) و (non-sepsis)، حيث أنّه يقارن بين (TPR=True Positive Rate) و (FPR=False Positive rate) عند قيم عتباتٍ مختلفةٍ. ومن الملاحظ أنّ المنحنى في الشّكل (1) يرتفع فوق الخط القطري ليعطي النّموذج قدرة تنبؤيّة أعلى من المصنّف العشوائيّ على الرّغم من أنّه لم يقترب بشكلٍ حادٍّ من الزّاوية العلويّة اليسرى (الّتي تمثّل الأداء العام المثالي للنّموذج). بالإضافة إلى حقيقة أنّ المنطقة أسفل المنحنى (AUC=Area Under ROC Curve) كلّما كانت قريبة باتجاه (1) كلّما دلّت على قدرة تصنيفٍ أفضل.
7. الخلاصة
وهكذا نرى من خلال هذه الدّراسة كيف يمكن لتقنيّة (ML-SVM) أن تحسّن بشكلٍ كبيرٍ النّهج العام لعلاج الإنتان من خلال إنشاء إطار تنبّؤي قادرٍ على الكشف بدقة عن بداية الإنتان، ويسهل من الإدارة الاستباقيّة له، ويدعم مسار تمكين الكوادر الطّبيّة في اتخاذ قراراتٍ أسرع وبكفاءةٍ أعلى. ممّا يسهم بتقليل معدلات الوفيّات قدر الإمكان وتحسين نتائج العلاج للمرضى.
وقد نوّه الفريق البحثي ضمن هذا العمل للعديد من النّقاط والتّحدّيات المهمة الّتي تحتاج حلولًا تطويريّةً واضحةً تعزّز من أداء النّموذج، نذكر منها:
- العقبة: عدم قدرة النّموذج على تعميم أدائه لفئاتٍ سكانيّةٍ مختلفةٍ أو وحدات (ICU)؛ لأنّ مجموعة البيانات قد تمثّل سمات ديموغرافيّة أو طبيّة محدّدة. الحل المقترح: التّركيز على توسيع مجموعة البيانات لتشمل شريحة أكبر من المرضى في بيئات (ICU) مختلفة.
- العقبة: عدم كفاية الخصائص المستخدمة في التّمييز بين الإنتان والعدوى الفيروسيّة وتحسين الكشف عنه. الحل المقترح: إمكانيّة الجمع بين الخصائص المستخدمة والتّعبير الجيني الّذي يساعد في التّمييز بين الأمراض إن كانت فيروسيّة أم بكتيريّة.
- العقبة: توافر المزيد من البيانات للمرضى. الحل المقترح: توفير تقييمات شخصيّة للمخاطر واقتراحات علاجيّة مخصّصة لكلّ مريض.
- العقبة: وجود تحيّزات كامنة ضمن مجموعة البيانات، مثل: عدم توازن توزيع العيّنات ضمن الأصناف الفئويّة المحدّدة مسبقًا. الحل المقترح: العمل على موازنة مجموعة البيانات لتقليل التّحيّز والبيانات غير المتوازنة (imbalanced data).
8. الملحق
يتناول هذا القسم جوانب التّقييمات المختلفة الّتي أُجريت تباعًا بين النّموذج المقترح (ML-SVM) وعدّة خوارزميّات وتقنيّات تنوّعت بين التّقليديّة والحديثة لإبراز مدى فعاليته وموثوقيّته في تمييز مرضى الإنتان.
ولكن لاتزال هناك حاجةٌ ملحةٌ لإجراء المزيد من الدّراسات حول تقييم جدوى هذه التّقنيّة في مختلف سياقات الرّعاية الصّحيّة المتخصّصة؛ لضمان متانة النّموذج وإمكانيّة تطبيقه في بيئاتٍ عالميّةٍ حقيقيّةٍ.
الجدول (1): تقييم أداء المنهج المقترح مقارنةً بطرق التّصنيف الحاليّة لمرضى الإنتان (sepsis).
الجدول (2): تقييم أداء المنهج المقترح مقارنةً بطرق التّصنيف الحاليّة للأفراد غير المصابين بالإنتان (without sepsis).
الجدول (3): مقارنة دقة النّهج المقترح بأساليب التّصنيف الحاليّة للكشف عن الإنتان.
الجدول (4): مقارنة الوقت.
الجدول (5): دقة التّحقق المتقاطع.